Linux e il nastro sembrano fatti per intendersi alla perfezione.
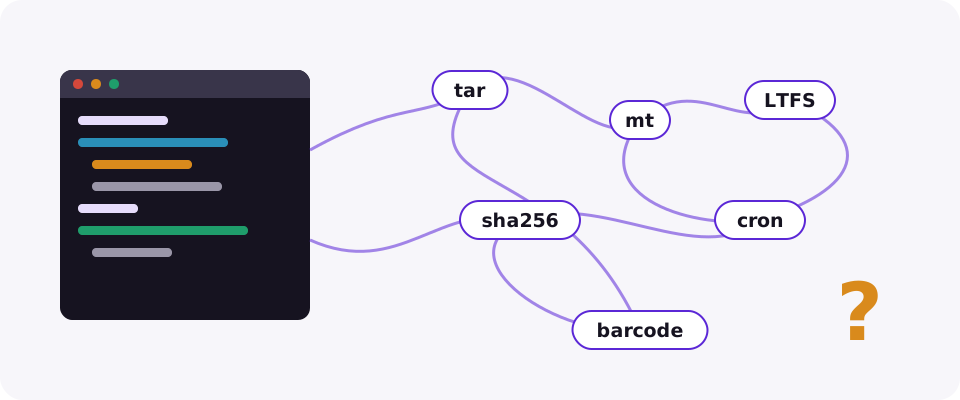
Gli strumenti sono flessibili, l'automazione è possibile. Potete scrivere script su misura, decidere la suddivisione dei dati, verificare tutto, gestire i cataloghi a modo vostro ed evitare costosi software se questo è il vostro obiettivo. Per l'operatore giusto, tale libertà è impagabile.
È anche il punto in cui molti flussi di lavoro su nastro diventano fragili.
La scriptabilità non coincide con la chiarezza operativa
Questa è la trappola.
Un flusso di lavoro su nastro personalizzato in Linux può apparire elegante nel terminale ed essere disastroso il giorno del ripristino: processi tar, comandi MT, mount LTFS, manifest personalizzati, indici generati, mappature dei codici a barre, file di checksum, logiche di staging... ogni singolo pezzo può avere perfetto senso da solo, mentre l'intero sistema risulta comprensibile solo a chi lo ha assemblato.
Le recenti discussioni sugli strumenti per nastro in ambiente Linux tornavano costantemente su questa tensione: si desideravano flussi scriptabili e trasparenti per ottimi motivi, evitando vincoli proprietari o formati catalogo chiusi, con processi ispezionabili e controllabili.
Questo istinto è positivo, ma rimane tale solo se il flusso operativo rimane comprensibile nel tempo.
Il nastro amplifica ogni debolezza nella documentazione
Perché il nastro non viene solitamente utilizzato ogni giorno con la massima intensità emotiva.
I job vengono eseguiti. I supporti ruotano. Passano settimane e mesi. Poi un giorno occorre recuperare un elemento importante e all'improvviso ogni presupposto non documentato diventa un rischio. A quale sequenza di nastri apparteneva quel set di archiviazione? Quale versione dello script ha scritto questo batch? La compressione era abilitata? Dov'è il manifest? Quale macchina conservava le note di ripristino? Il catalogo è abbastanza isolato da sopravvivere al guasto che ha reso necessario il ripristino?
Un flusso di lavoro scriptabile che non risponde chiaramente a queste domande non è ancora maturo, a prescindere da quanto appaia ingegnoso lo script di shell.
I buoni flussi su nastro Linux sono rigorosamente espliciti
Questo è lo standard a cui puntare.
Generano manifest con coerenza. Registrano cosa è andato dove. Verificano le scritture. Documentano le fasi di ripristino all'esterno della macchina che esegue i backup. Rendono prevedibile la suddivisione tra più supporti. Definiscono regole di etichettatura. Evitano trucchi improvvisati. In breve, sacrificano un po' di eleganza per una grande capacità di sopravvivenza dei dati.
Ecco perché alcuni team passano gradualmente da “una serie di script intelligenti” a un software di backup completo: non perché Linux abbia deluso, ma perché i limiti dei propri processi sono diventati più importanti del piacere del controllo manuale.
E talvolta accade il contrario: un flusso di lavoro Linux accuratamente strutturato rimane la risposta ideale perché gli operatori sono abbastanza disciplinati da mantenerlo duraturo.
Entrambi i risultati vanno bene. Il vero rischio è presumere che l'esistenza di alcuni script equivalga all'esistenza di un sistema di backup.
Non è affatto così.
Il nastro richiede disciplina; Linux offre gli strumenti per applicarla al meglio o per aggirarla abilmente. La differenza non la fa la piattaforma, ma se il processo resta chiaro quando chi l'ha scritto è assente, stanco o sotto pressione durante un incidente reale.
Questo è il criterio: la programmabilità è una funzione, la recuperabilità è l'obiettivo fondamentale.